 Menu
 Enguerrand Sagot
Concevoir un système d’information performant, fiabiliser ses données ou réussir un projet de Business Intelligence (BI) commence presque toujours par la même étape : la construction d’un bon modèle de données. Pourtant, ce sujet reste souvent perçu comme une affaire de spécialistes techniques, réservée aux data engineers ou aux architectes.
En réalité, un modèle de données bien pensé est un enjeu stratégique pour toute l’organisation. Il conditionne la qualité de vos analyses, la fiabilité de vos indicateurs de pilotage, la rapidité de vos projets IT et, plus largement, la capacité de votre entreprise à exploiter durablement ses données.
Dans ce guide, vous allez apprendre :
- ce qu’est vraiment un modèle de données
- les différents niveaux de modélisation (conceptuel, logique, physique)
- les principales approches : relationnel, dimensionnel, NoSQL
- le rôle de l’architecture de données dans la conception des modèles
- comment construire un modèle de données fiable en 5 étapes
- les erreurs les plus fréquentes à éviter
Qu’est-ce qu’un modèle de données ?
Concrètement, c’est le plan de construction sur lequel repose l’ensemble d’un système d’information : bases de données transactionnelles, entrepôts de données, référentiels métier ou outils de reporting.
Un bon modèle de données permet de répondre à des questions simples mais essentielles :
- Quelles sont les entités clés de mon activité (client, produit, commande, contrat…) ?
- Comment ces entités sont-elles liées entre elles ?
- Quelles règles métier doivent être respectées (unicité, contraintes, cardinalités) ?
Sans modèle clair, les données s’accumulent sans structure cohérente. Résultat : des doublons, des incohérences entre systèmes, et des données de plus en plus difficiles à exploiter au fil du temps.
Pourquoi un modèle de données est stratégique pour l’entreprise
1. Fiabiliser et sécuriser la donnée
Un modèle de données solide garantit la cohérence et l’intégrité des informations. En formalisant les règles métier comme l’unicité, les relations ou encore les contraintes, il évite les doublons, les conflits de formats et les erreurs de saisie qui, sans cadre, se propagent dans tout le système d’information.Une donnée mal modélisée à la source coûte toujours plus cher à corriger a posteriori qu’à cadrer en amont.
2. Accélérer les projets IT et data
Un modèle de données bien conçu sert de langage commun entre les équipes métier et les équipes techniques. Il devient la référence pour tout projet de migration, d’intégration ou de mise en place d’un outil de reporting : moins d’allers-retours, moins de ré-interprétations, des livraisons plus rapides.
Il permet aussi d’anticiper les évolutions. Ajouter une nouvelle source de données, intégrer une application tierce ou faire évoluer un système existant devient beaucoup plus simple lorsque la structure est documentée et maîtrisée.
3. Fiabiliser la prise de décision
Un dashboard ou une data visualisation n’a de valeur que si les données qui l’alimentent sont fiables et bien structurées. Un modèle de données mal conçu se traduit tôt ou tard par des chiffres incohérents entre deux rapports, des KPI difficiles à interpréter, ou des analyses biaisées.
Les 3 niveaux de modélisation des données
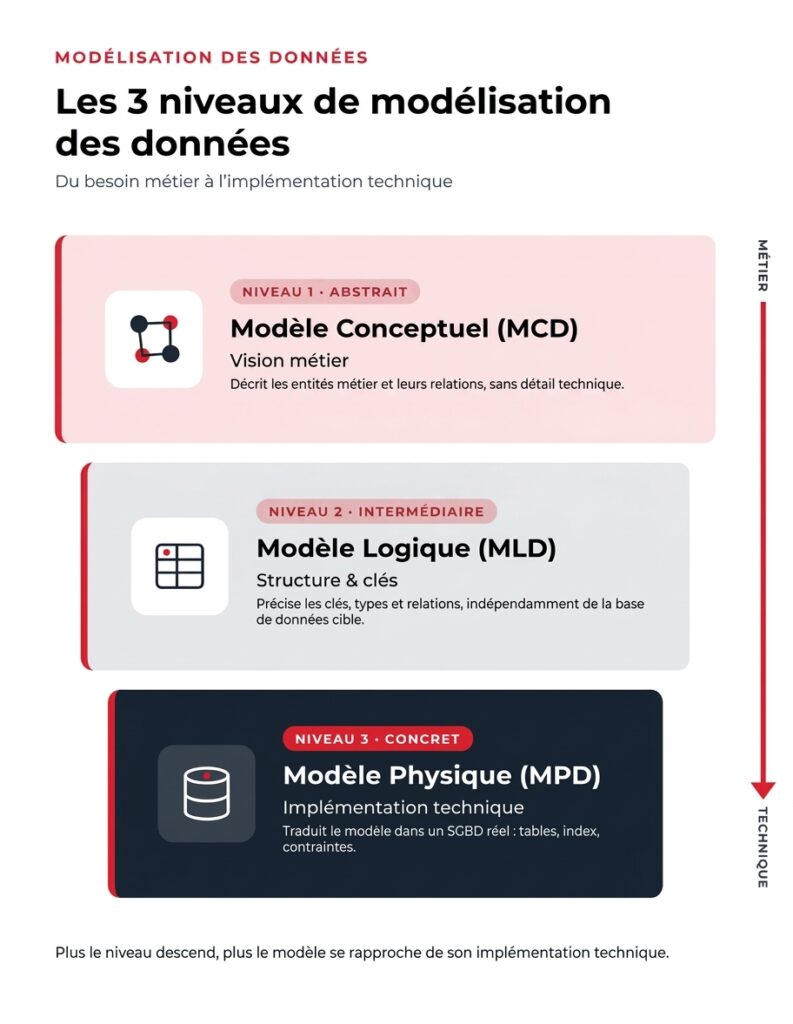
La modélisation des données se construit généralement en trois niveaux successifs, du plus abstrait au plus technique.
Le modèle conceptuel (MCD)
Le modèle conceptuel décrit les entités métier client, produit, commande et leurs relations, sans aucune considération technique. Il est destiné aux échanges avec les experts métier et constitue la première étape d’une bonne compréhension des besoins.
Parmi les règles définies au niveau conceptuel, les cardinalités occupent une place centrale. Elles précisent combien d’occurrences d’une entité peuvent être associées à une autre à travers une relation donnée.
On distingue généralement trois types de cardinalités :
- Un à un (1,1) : chaque occurrence d’une entité est liée à une seule occurrence de l’autre. Exemple : un contrat est rattaché à un seul client.
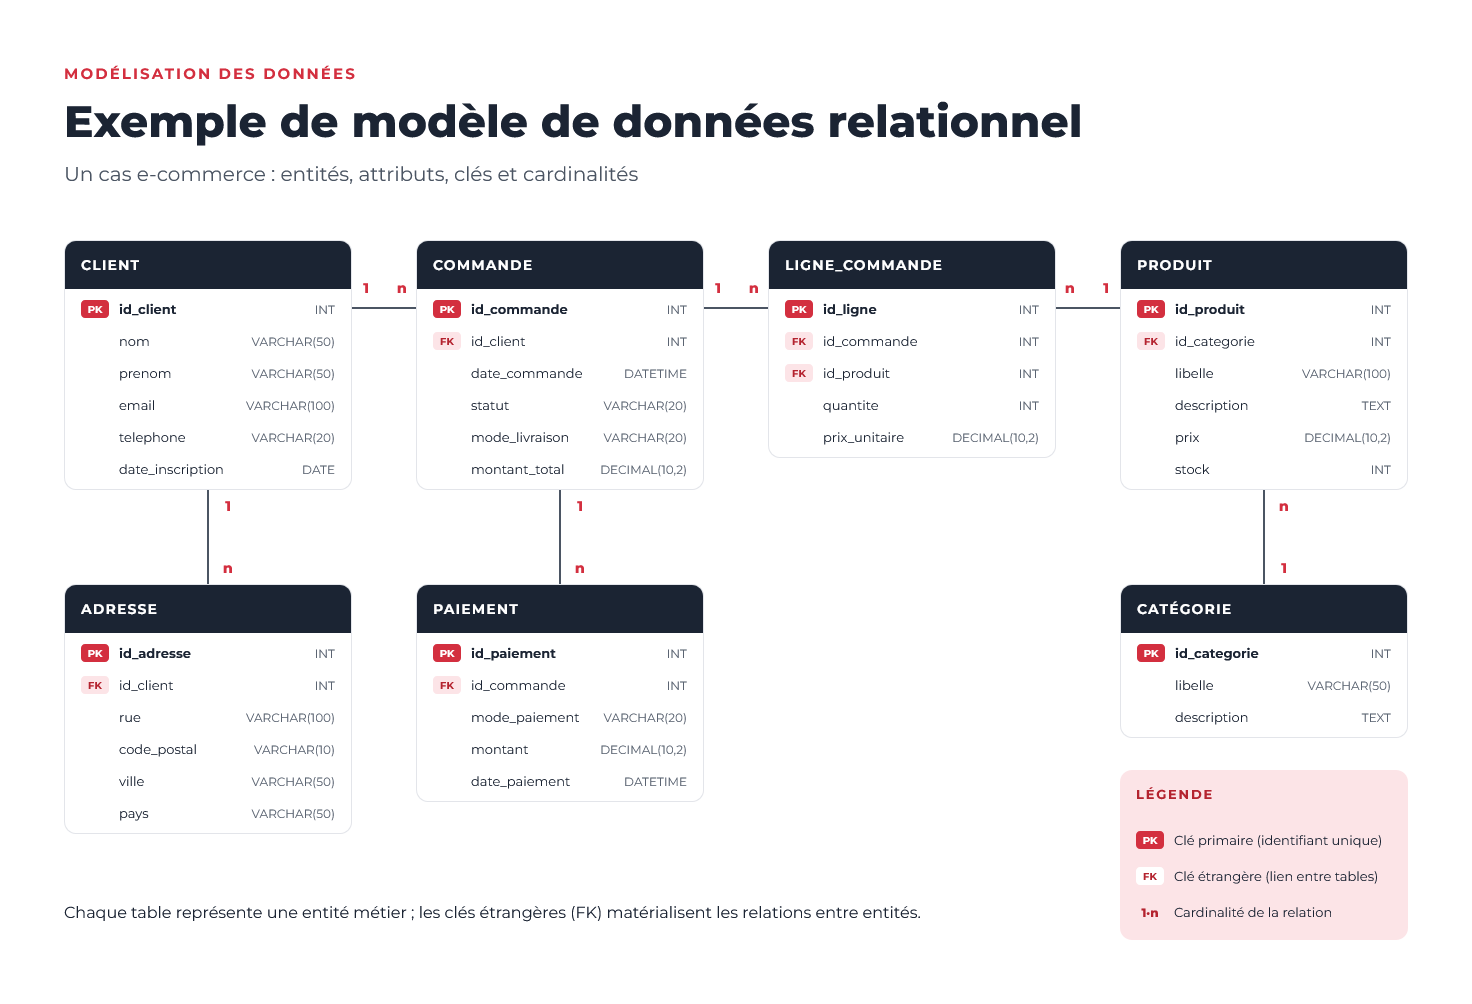
- Un à plusieurs (1,n) : une occurrence peut être liée à plusieurs occurrences de l’autre entité. Exemple : un client peut passer plusieurs commandes, mais chaque commande n’appartient qu’à un seul client.
- Plusieurs à plusieurs (n,n) : chaque occurrence peut être liée à plusieurs occurrences de l’autre, et réciproquement. Exemple : un produit peut apparaître dans plusieurs commandes, et une commande peut contenir plusieurs produits.
Bien définir ces cardinalités dès le modèle conceptuel évite des erreurs coûteuses en aval : une cardinalité mal posée peut entraîner une relation manquante, une table de jointure oubliée, ou des doublons dans les données collectées.
Le modèle logique (MLD)
Le modèle logique traduit le conceptuel en une structure plus précise, adaptée à un type de base de données (relationnelle, orientée document…). Il définit les clés, les types de relations et les attributs, sans encore imposer d’implémentation physique.
Le modèle physique (MPD)
Le modèle physique traduit le modèle logique dans le langage d’un système de gestion de base de données spécifique (PostgreSQL, SQL Server, Snowflake…). Il inclut les index, les contraintes techniques et les partitions, et peut être directement exécuté.
Plus la construction du modèle conceptuel est rigoureuse, plus la transition vers le modèle logique puis physique sera fluide et fiable. C’est un point de vigilance trop souvent négligé : beaucoup d’entreprises passent directement au modèle physique, sans avoir formalisé le conceptuel.
Pour aller plus loin sur la construction d’un modèle de données à l’échelle d’une organisation entière, découvrez notre article dédié à l’Enterprise Data Model.
Les principales approches de modélisation
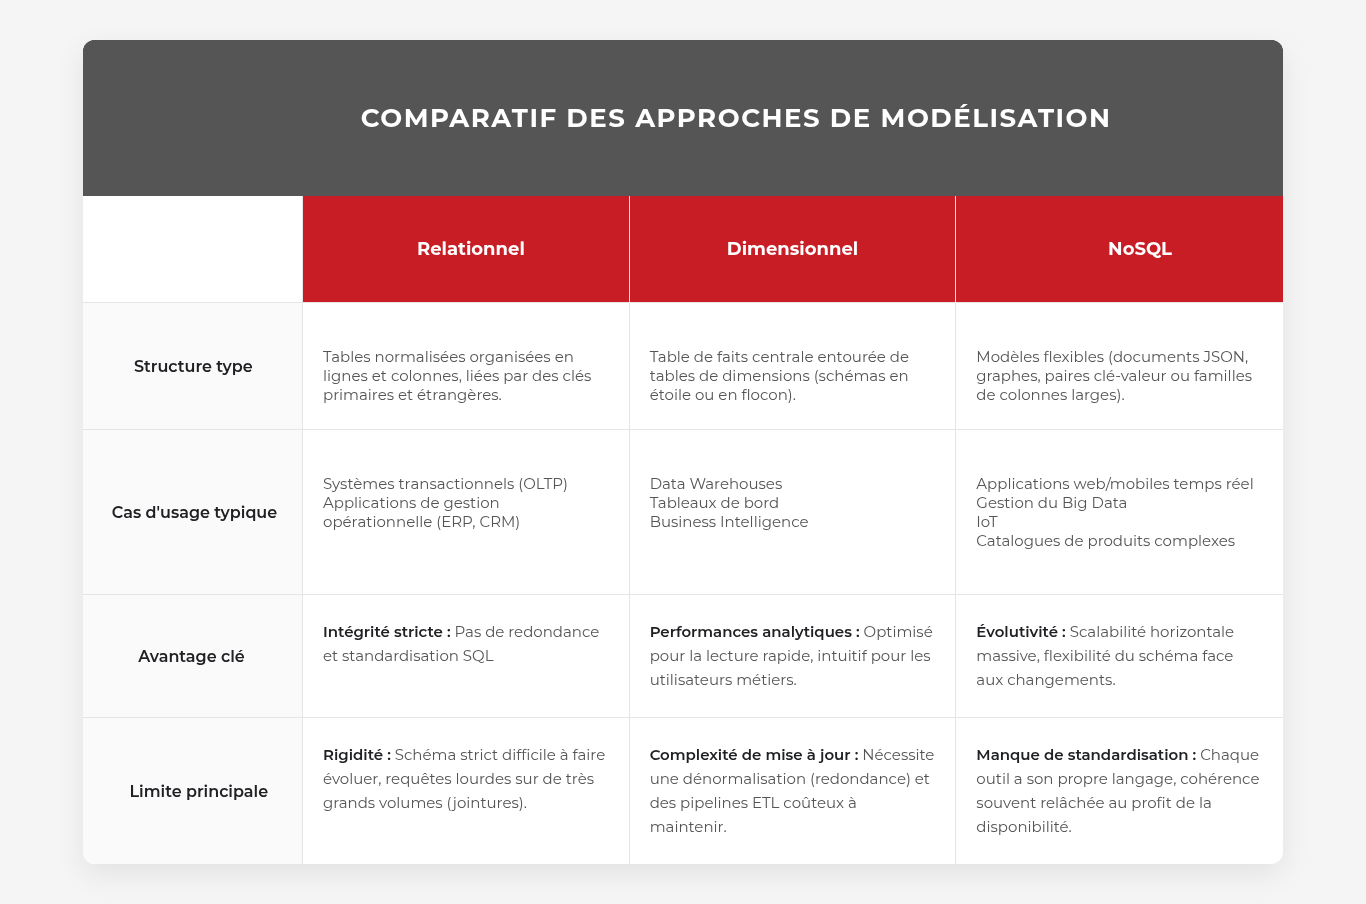
1. Le modèle relationnel
Le modèle relationnel est l’approche la plus répandue et la plus ancienne. Les données sont organisées en tables reliées entre elles par des clés primaires et étrangères, et normalisées pour limiter la redondance.
Le modèle relationnel est particulièrement adapté aux bases de données transactionnelles : ERP, CRM, applications métier.
2. Le modèle dimensionnel (schéma en étoile)
Le modèle dimensionnel est conçu pour l’analytique, le modèle dimensionnel repose sur une table de faits centrale entourée de tables de dimensions. Popularisé par Ralph Kimball dans les années 1990, il reste aujourd’hui la référence pour construire des entrepôts de données et des dashboards performants, car il facilite les requêtes d’analyse sur de gros volumes.
3. Les modèles NoSQL
Pour des besoins de flexibilité ou de forte volumétrie, les modèles NoSQL (orientés document, graphe, clé-valeur ou colonne) s’affranchissent d’un schéma rigide. Ils sont pertinents lorsque la structure des données évolue souvent, ou lorsque le volume et la vitesse de traitement priment sur la rigueur du schéma relationnel.
4. Quel modèle choisir ?
Il n’existe pas de modèle de données universellement adapté à tous les projets. Le bon choix dépend avant tout de l’usage des données, du niveau de performance attendu, de leur volume, de leur structure et des contraintes métier. Autrement dit, il faut choisir le modèle en fonction de ce que les données doivent permettre de faire, et non l’inverse.
- Pour un système transactionnel : le modèle relationnel reste généralement le choix naturel. Il convient lorsque les données doivent être fortement structurées, cohérentes et régulièrement mises à jour : gestion des clients, commandes, contrats, stocks ou opérations comptables. La normalisation permet notamment de limiter les redondances et de faire respecter les contraintes métier.
- Exemple : Une application bancaire gérant les comptes des clients, les virements et l’historique des transactions financières
- Pour l’analyse et le reporting, le modèle dimensionnel est particulièrement adapté. Un schéma en étoile facilite les requêtes de filtrage, d’agrégation et de comparaison dans le temps. Il est donc bien adapté aux data warehouses, aux outils de Business Intelligence et aux dashboards, notamment lorsque les utilisateurs doivent explorer rapidement de grands volumes de données.
- Exemple : Un tableau de bord de Business Intelligence (type Power BI ou Tableau) utilisé par une enseigne de e-commerce pour analyser les ventes globales par région, par catégorie de produits et par trimestre.
- Pour des données très variables ou des applications nécessitant une forte capacité de mise à l’échelle, une approche NoSQL peut être pertinente. Les bases documentaires, clé-valeur, orientées colonnes ou graphes répondent toutefois à des besoins différents : le choix d’une technologie NoSQL doit donc être guidé par le type de données, les accès attendus et les contraintes de performance, plutôt que par le seul volume de données.
- Exemple : Une plateforme de streaming (comme Netflix ou Spotify) stockant les profils utilisateurs, les recommandations personnalisées et le catalogue de contenus aux formats variés et évolutifs
5. Les principaux critères à prendre en compte
Pour choisir un modèle de données, plusieurs questions permettent de cadrer rapidement la décision :
- Quel est l’usage principal ? Transaction, reporting, analyse, application temps réel, recherche ou traitement de données ?
- Quelle est la structure des données ? Très structurée, semi-structurée ou amenée à évoluer fréquemment ?
- Quel niveau de cohérence est nécessaire ? Certaines applications nécessitent des contraintes fortes entre les données et des mises à jour transactionnelles fiables.
- Quel volume et quelle croissance prévoir ? Un modèle adapté à quelques millions de lignes peut nécessiter une architecture différente à très grande échelle.
- Quelles sont les contraintes de performance ? Temps de réponse, fréquence des écritures, complexité des requêtes et peuvent orienter le choix.
- Quel est l’écosystème existant ? Technologies déjà utilisées, compétences disponibles, outils de BI et contraintes d’intégration doivent également être pris en compte.
6. Les architectures de données : le cadre qui structure vos modèles
Un modèle de données s’inscrit toujours dans une architecture de données qui définit comment les données sont structurées, transformées et mises à disposition. Lorsque ses principes sont clairs, la définition des modèles en est facilitée. L’approche la plus répandue est l’architecture en couches, illustrée par exemple avec l’architecture médaillon :
- Bronze : les données brutes, conservées telles qu’issues des sources.
- Silver : les données nettoyées et harmonisées, souvent dans un modèle relationnel normalisé.
- Gold : les données prêtes pour les usages métier, généralement dans un modèle dimensionnel optimisé pour la BI.
Chaque couche ayant un rôle précis, le choix du modèle devient plus simple et plus cohérent.
Comment construire un bon modèle de données (méthode en 5 étapes)
Construire un modèle de données ne consiste pas simplement à dessiner des tables et des liens. Un bon modèle doit refléter fidèlement les besoins métier, rester lisible et pouvoir évoluer dans le temps. Voici une méthode simple en 5 étapes.
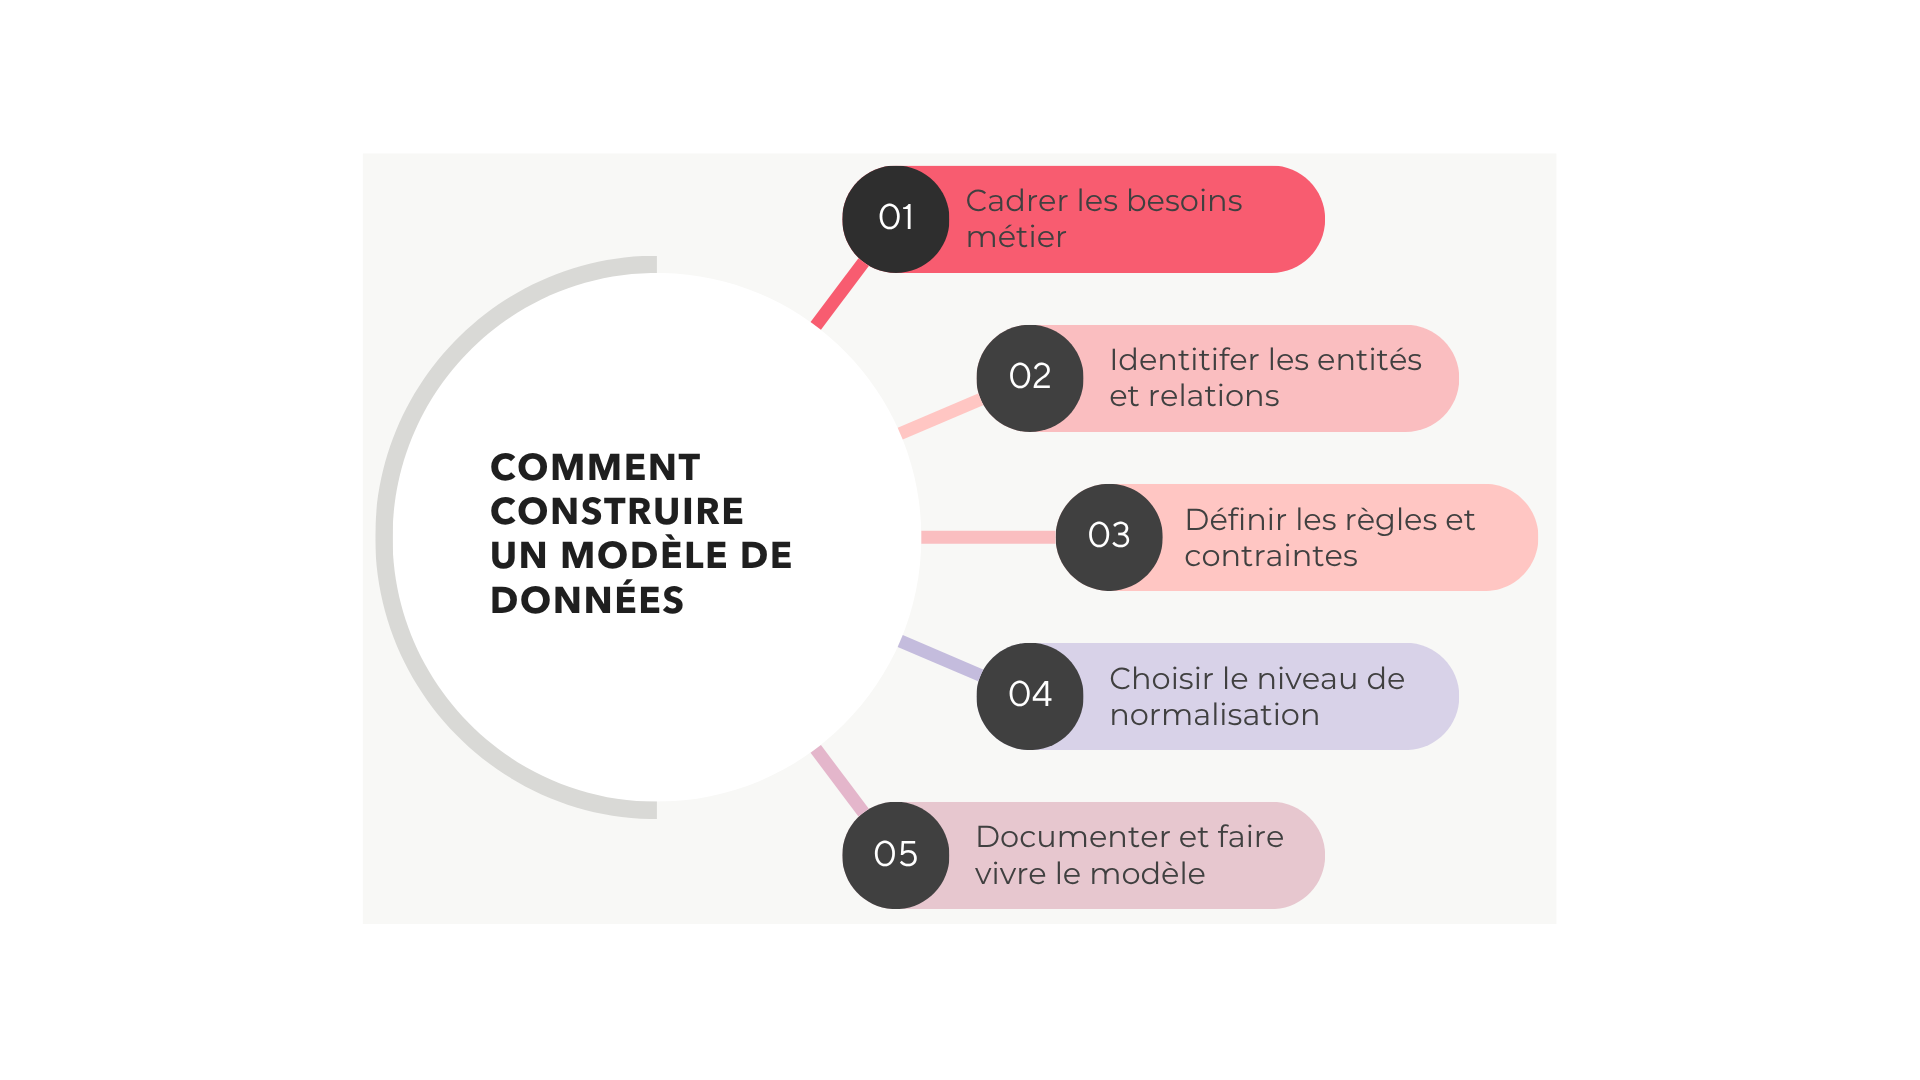
Étape 1 : cadrer les besoins métier
Avant de modéliser quoi que ce soit, il faut comprendre ce que le modèle doit servir : quel processus métier, quelles décisions, quels usages (transactionnel, reporting, IA). Un modèle construit sans objectif clair devient rapidement trop complexe ou inadapté. (Cf. 5. Les principaux critères à prendre en compte).
Étape 2 : identifier les entités et leurs relations
L’étape suivante consiste à lister les objets métier essentiels comme les clients, les produits, les commandes ou les contrats et à définir comment ils interagissent entre eux. C’est le cœur du modèle conceptuel, et la base de tout ce qui suivra.
Étape 3 : définir les règles et les contraintes
Chaque relation doit être précisée : cardinalités, unicité, obligations. Ces règles métier, une fois formalisées, deviennent les garde-fous qui garantissent la cohérence des données dans la durée.
Étape 4 : choisir le niveau de normalisation adapté
Normaliser un modèle de données, c’est-à-dire organiser et structurer les tables pour éviter de stocker plusieurs fois la même information, permet de limiter la redondance et les incohérences (par exemple, stocker l’adresse d’un client à un seul endroit plutôt que dans chaque commande). Mais, une normalisation excessive peut nuire aux performances analytiques. L’enjeu est de trouver le bon équilibre selon l’usage : un système transactionnel privilégiera la normalisation, un entrepôt analytique acceptera davantage de dénormalisation pour gagner en rapidité de requête.
Étape 5 : documenter et faire vivre le modèle
Un modèle de données n’est jamais figé. Il doit être documenté via des glossaires, des dictionnaires de données ou encore des schémas à jour puis révisé à mesure que l’activité évolue. Un modèle non documenté perd rapidement de sa valeur, car plus personne ne sait vraiment ce qu’il représente.
Les erreurs à éviter en modélisation des données
Même avec les meilleurs outils, un modèle de données mal pensé finit toujours par générer des problèmes en cascade.
Erreurs fréquentes chez les débutants
- Modéliser directement en physique, sans étape conceptuelle : on perd la vision métier et on complique les évolutions futures.
- Ignorer les cardinalités et contraintes : source fréquente de doublons et d’incohérences.
- Sur-simplifier le modèle : à l’inverse, un modèle trop pauvre ne reflète pas la réalité métier et devient vite inutilisable.
- Ne pas documenter : un modèle non documenté devient illisible dès que l’équipe change.
Erreurs fréquentes chez les profils avancés
- Sur-normaliser un modèle analytique : à vouloir éliminer toute redondance, on complexifie inutilement les requêtes et on dégrade les performances.
- Dupliquer les référentiels : plusieurs définitions d’un même objet métier (client, produit) selon les systèmes, sans référentiel unique.
- Négliger la gouvernance : un modèle technique parfait mais déconnecté des règles de gouvernance de la donnée finit par diverger du réel.
- Concevoir sans anticiper la volumétrie : un modèle qui fonctionne à petite échelle peut s’effondrer en performance une fois le volume de données multiplié.
Modèle de données et gouvernance : deux disciplines indissociables
Un modèle de données, aussi bien conçu soit-il, ne suffit pas à lui seul. Il doit s’inscrire dans une démarche plus large de gouvernance de la donnée, qui définit qui est responsable de quoi, quels standards s’appliquent, et comment les évolutions du modèle sont validées dans le temps.
C’est également dans le cadre de l’architecture de données que le modèle prend tout son sens : il devient la référence partagée permettant de distribuer, intégrer et faire évoluer les données à l’échelle du système d’information.
Chez Redsen, ces deux dimensions sont complémentaires et font partie de notre accompagnement. Nos experts interviennent aussi bien sur les enjeux de gouvernance de la donnée tels que la maturité, la qualité, les référentiels, les rôles et processus ainsi que sur les enjeux d’architecture de données, notamment la structuration des modèles, la gestion des métadonnées et l’intégration des données dans le système d’information.
Vous souhaitez structurer vos données pour vos projets BI ?
Concevoir un modèle de données n’est pas un exercice technique isolé. Bien construit, il devient un véritable actif stratégique : il fiabilise les données, accélère les projets IT, et donne aux équipes métier une base solide pour piloter leur activité.
Maîtriser la modélisation des données, ce n’est pas seulement savoir dessiner des tables et des relations. C’est savoir aligner la structure des données sur les besoins métier, anticiper les usages futurs et documenter les choix pour que le modèle reste exploitable dans la durée.
Vous avez des difficultés à définir votre modèle de données et la vision de votre architecture de données pour vos tableaux de bord BI ? Nos experts vous accompagnent.
Chez Redsen, nous accompagnons les entreprises sur l’ensemble de cette chaîne de valeur, de la conception du modèle de données à sa mise en œuvre dans des systèmes d’information robustes et évolutifs. Notre approche s’inscrit dans une logique de performance, avec une vision à la fois analytique, métier et opérationnelle.
Vous souhaitez aller plus loin ? Nos experts peuvent vous partager des exemples concrets de cas clients, vous aider à évaluer la maturité de votre modélisation actuelle et identifier rapidement vos principaux axes d’amélioration.
Pour cela, vous pouvez nous contacter via notre formulaire pour :
- découvrir des exemples concrets de projets menés chez nos clients,
- échanger avec un expert sur vos enjeux de modélisation et d’architecture de données,
- réaliser un audit flash de votre data management,
- identifier des leviers d’optimisation en modélisation, gouvernance et architecture de données.
Un premier échange permet souvent de faire émerger des gains rapides, concrets et directement activables.
FAQ – Modèles de données : ce qu’il faut retenir
Qu'est-ce qu'un modèle de données ?
Un modèle de données est une représentation structurée des entités, attributs et relations qui composent les données d'une organisation. Il sert de plan de construction pour les bases de données, les entrepôts de données et les outils de reporting.
Quels sont les 3 niveaux de modélisation des données ?
On distingue le modèle conceptuel (MCD), qui décrit les entités métier et leurs relations, le modèle logique (MLD), qui précise les clés et les types de relations, et le modèle physique (MPD), qui traduit le tout dans un système de gestion de base de données spécifique.
Quelle est la différence entre un modèle relationnel et un modèle dimensionnel ?
Le modèle relationnel organise les données en tables normalisées, adaptées aux systèmes transactionnels. Le modèle dimensionnel, construit autour d'une table de faits et de tables de dimensions, est optimisé pour l'analyse et les entrepôts de données.
Comment créer un bon modèle de données ?
Un bon modèle de données repose sur une méthode simple : cadrer les besoins métier, identifier les entités et leurs relations, définir les règles et contraintes, choisir le bon niveau de normalisation, puis documenter et faire vivre le modèle dans le temps.
Quelle est la différence entre modèle de données et gouvernance des données ?
Le modèle de données définit la structure et l'organisation des données. La gouvernance des données définit les règles, les rôles et les responsabilités qui encadrent leur gestion. Les deux disciplines sont complémentaires et indissociables pour exploiter durablement ses données.
Quels outils utiliser pour modéliser des données ?
Les outils les plus utilisés sont PowerDesigner ou dbdiagram.io pour la modélisation relationnelle, ainsi que les fonctionnalités de modélisation intégrées aux entrepôts de données cloud (Snowflake, BigQuery, Databricks) pour la modélisation dimensionnelle.